Xiaomi ouvre un modèle léger capable d'interroger un PDF comme un humain
— AGENTS
Xiaomi publie en accès libre un modèle de 800 millions de paramètres capable de lire un document et de répondre à des questions sur son contenu, pas seulement d'en recopier le texte. Les scores affichés varient selon les tableaux de comparaison, et l'écart entre les classements publics mérite d'être regardé avant tout déploiement sérieux.
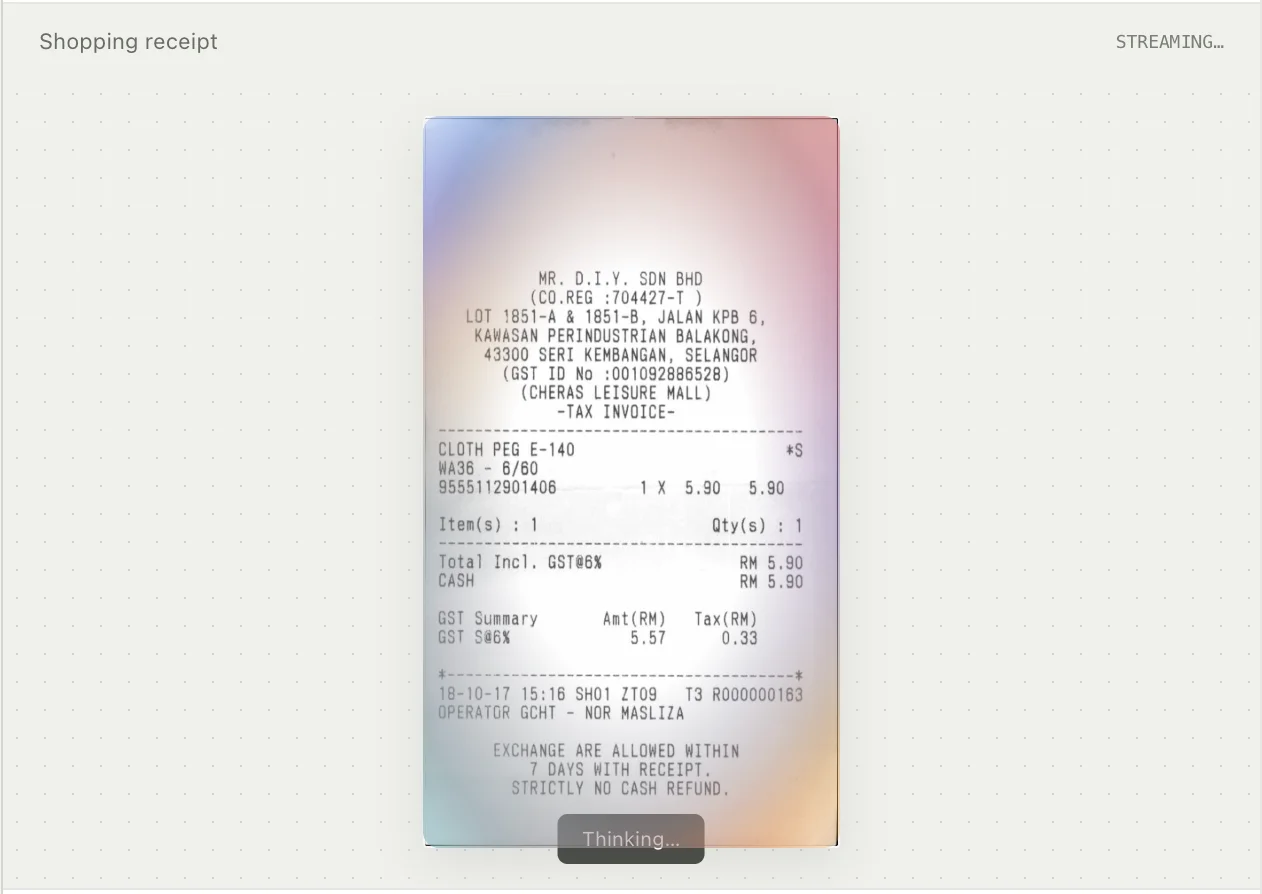
Un PDF scanné, une facture photographiée de travers, un tableau aux cellules fusionnées : ce sont des cauchemars classiques pour les logiciels qui se contentent de reconnaître des caractères. Xiaomi publie un modèle qui prétend aller plus loin, en comprenant la structure d'un document et en répondant à des questions posées dessus. Le modèle pèse 800 millions de paramètres, une fraction de la taille des géants généralistes, et ses poids sont ouverts.
Ce sujet ne concerne aucun atelier de création au sens strict. Il parle aux équipes techniques qui construisent des automatisations documentaires et aux développeurs qui assemblent des agents IA capables de traiter des archives, des contrats ou des rapports scientifiques sans intervention humaine systématique. Xiaomi fournit même un service pensé pour que ces agents appellent directement les fonctions de lecture et d'extraction, brique par brique.
Ce type de modèle compact et gratuit pèse sur le rapport de force entre les géants qui facturent l'accès à leurs API et les alternatives qu'une entreprise peut faire tourner sur ses propres machines. Une version communautaire tient en 1,8 gigaoctet, soit la taille d'un film en haute définition, de quoi l'installer sur un poste de travail standard sans dépendre d'un service distant. Pour des organisations soucieuses de garder des documents confidentiels chez elles, l'argument pèse lourd dans une négociation de prestataire.
La prudence s'impose pourtant sur les chiffres mis en avant. Le score revendiqué de 95,24 sur l'un des tests de référence ne correspond pas à celui affiché sur le classement public du même jeu de données, qui tombe à 92,73. Sans explication claire sur l'origine de cet écart, la place de numéro un revendiquée reste à prendre avec une pincette, liée à un protocole précis plutôt qu'à une performance universelle.
L'exercice reste révélateur d'un mouvement plus large : un modèle spécialisé et entraîné sur un corpus massif dépasse désormais des modèles généralistes bien plus lourds sur des tâches ciblées. La compétition ne se joue plus uniquement sur la taille, elle se joue sur la qualité des données d'entraînement et la spécialisation du système. Pour les studios qui s'appuient déjà sur des outils de gestion documentaire en coulisses, l'intelligence qui y tournera demain coûtera moins cher à faire fonctionner, sans qu'ils aient jamais besoin d'y réfléchir.