Un modèle de vision tient en 22 Mo et transforme une photo en données exploitables
— IMAGE
Mirage ne décrit plus une image, il la découpe en contours, textes et relations consultables séparément, dans un fichier assez léger pour tourner sur un téléphone. Les tests montrent aussi qu'une erreur de détection se propage jusqu'à la réponse finale, sans que rien ne la signale.
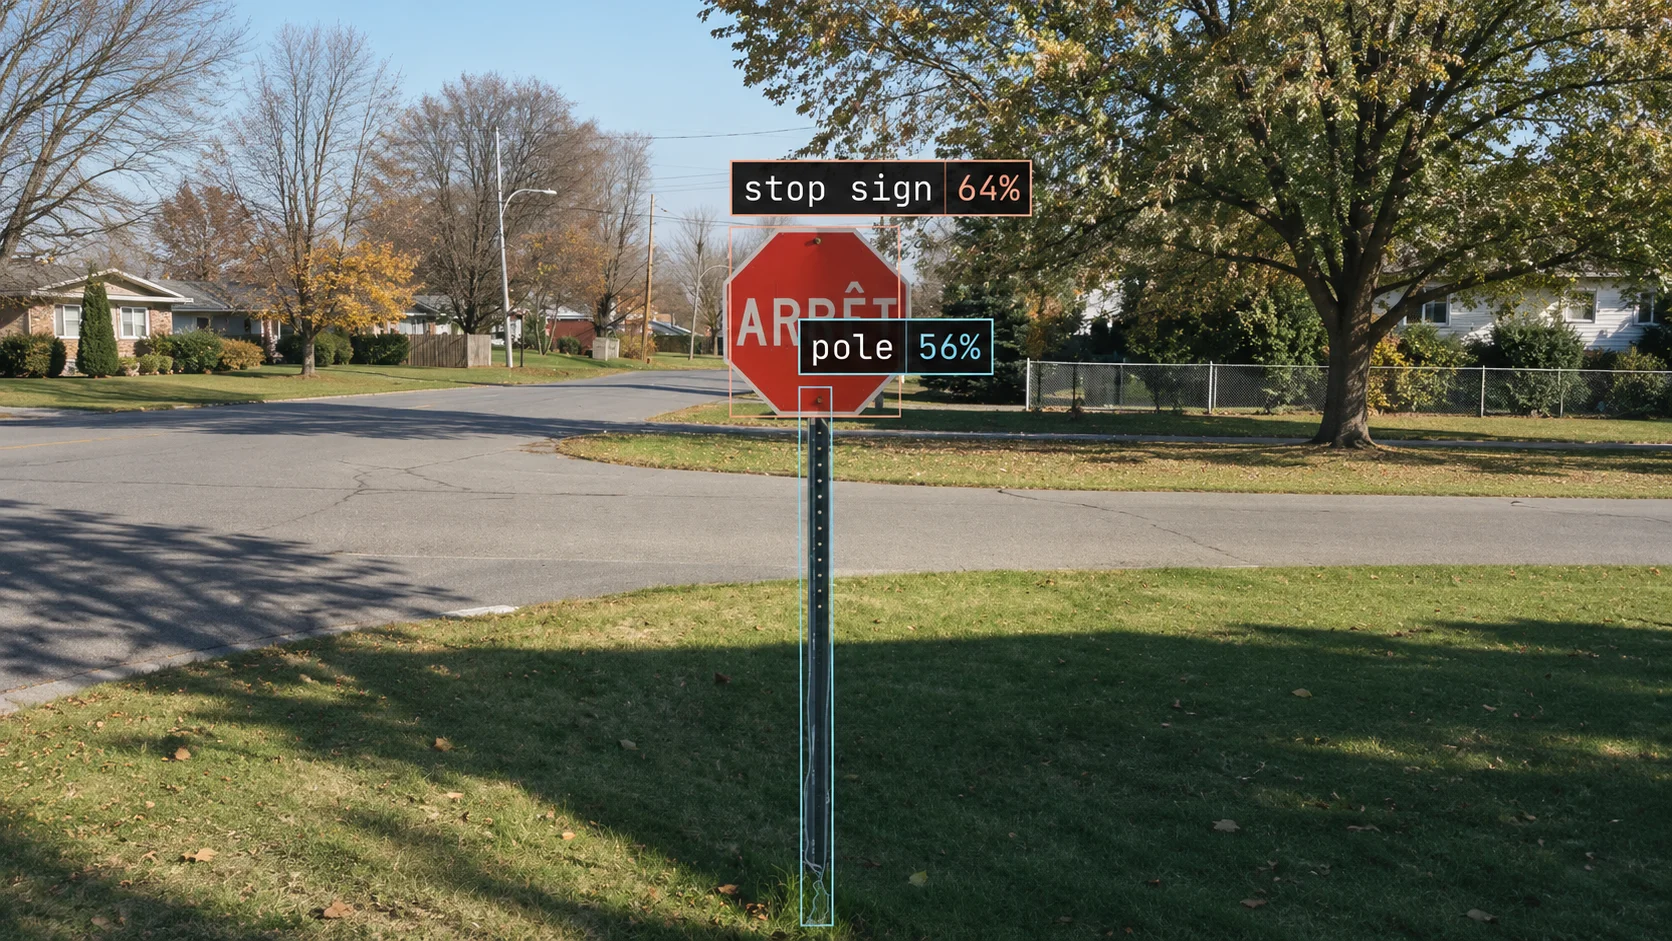
Un panneau stop photographié donne trois informations séparées chez Mirage : sa position, sa forme, son texte. Chacune reste consultable isolément, dans un fichier structuré, pendant qu'une légende classique aurait tout fondu dans une phrase qui oublie parfois le poteau ou l'inscription. Cette séparation change la nature de l'objet : une photo devient une base de données qu'on interroge plusieurs fois sans relancer l'analyse à chaque question.
Le fichier qui porte ce modèle pèse 21,6 Mo, soit la taille d'une poignée de photos haute définition, et tourne directement sur la puce d'un téléphone en une fraction de seconde. Cette légèreté vise les développeurs qui embarquent de la vision par ordinateur dans des applications mobiles, pas les studios créatifs eux-mêmes. Mais ce type de brique, ouverte sous licence Apache 2.0, finira par nourrir des fonctions de tri automatique ou de recherche visuelle dans les outils de gestion d'assets que les graphistes et photographes utilisent déjà pour trier leurs banques d'images.
Les essais menés par Cactus Compute montrent l'intérêt du relevé détaillé : un modèle de langage qui répond à des questions sur une image voit son score passer de 9,3 à 33,1 sur 100 quand il reçoit les champs structurés plutôt qu'une simple description. L'écart est net, et il valide l'idée qu'un relevé fin aide mieux un système à raisonner qu'un résumé général.
La limite tient à la fiabilité de ce qui est détecté en amont. Sur une photo, Mirage confond un téléviseur avec une balance numérique, et le modèle de langage qui lit ensuite ce relevé reprend l'erreur telle quelle. Sur une autre image, un skateboard disparaît du relevé au profit de voitures inventées. Le format structuré organise l'information, il ne garantit jamais qu'elle est exacte.
Pour un studio qui imaginerait automatiser le tagging de ses visuels ou l'indexation d'un catalogue produit, cette architecture ouvre une piste sérieuse, à condition de prévoir une vérification humaine sur les champs critiques, texte d'étiquette ou nom d'objet en tête. L'outil structure bien, il ne juge pas.