Liquid AI tasse six intelligences compactes dans la mémoire d'un smartphone
— AGENTS
Les six modèles LFM3 tournent sur un GPU unique ou un téléphone, sans passer par un serveur distant. Cette logique de poids réduits pèsera directement sur le prix et la disponibilité des outils qui s'appuieront demain sur ce type de moteur.
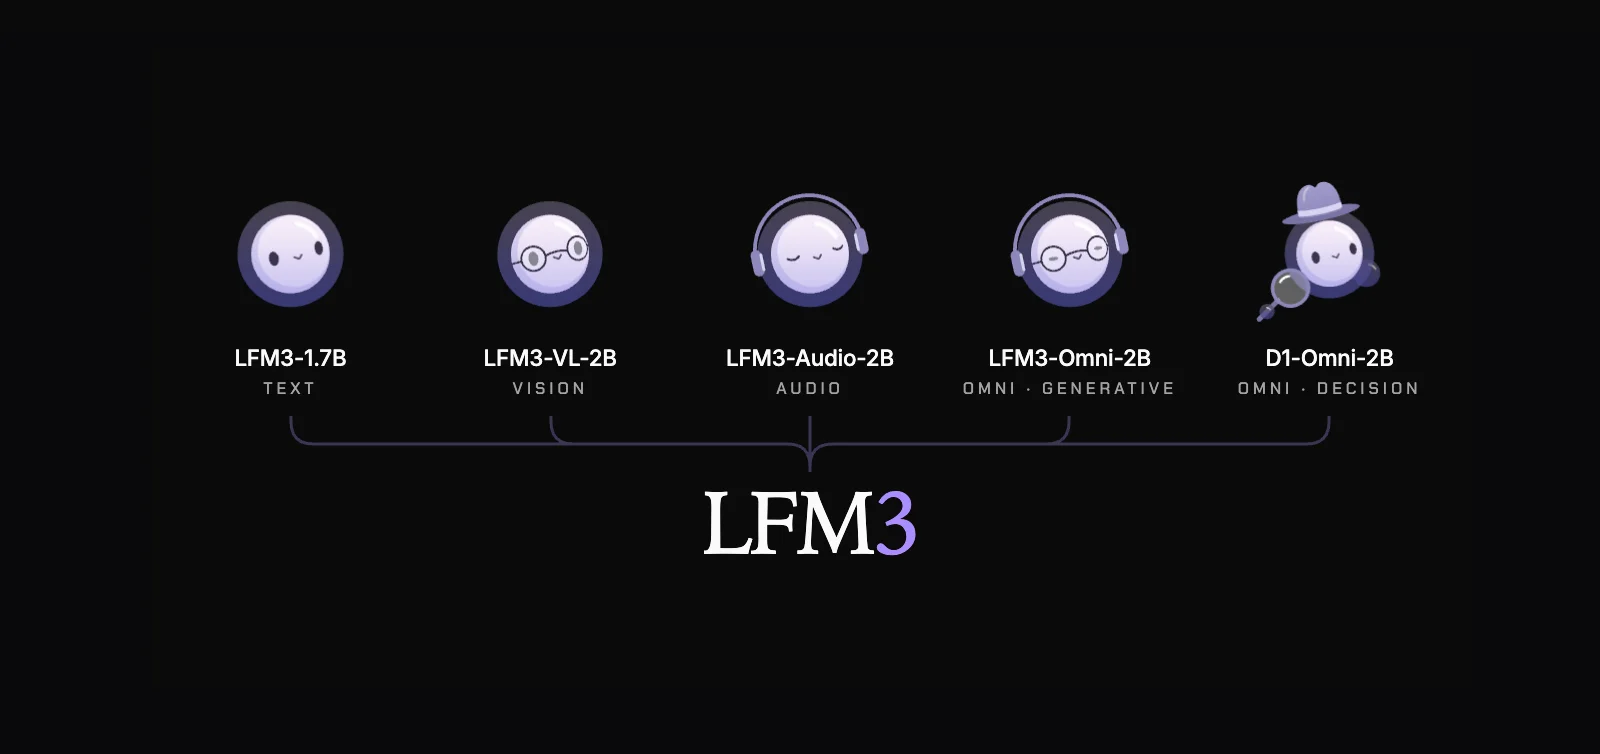
Liquid AI construit depuis trois générations une famille de modèles qui tiennent sur du matériel ordinaire, plutôt que d'empiler des paramètres dans des centres de données géants. Avec LFM3, six déclinaisons se partagent la même architecture pour couvrir le texte, l'image, la vidéo, l'audio et la prise de décision automatisée. Le point commun : des poids assez légers pour être adaptés et exécutés sur un ordinateur personnel, un smartphone ou une carte embarquée.
La version textuelle tient à elle seule dans environ un gigaoctet de mémoire une fois compressée, un format qui rentre sans forcer sur un ordinateur de bureau classique. C'est ce chiffre qui résume l'ambition de la gamme : faire tourner des assistants capables de suivre de longues conversations ou d'enchaîner des tâches outillées, sans dépendre d'un abonnement cloud payé à chaque requête.
Aucune des six variantes ne s'adresse directement à un studio de création. Les usages mis en avant concernent l'inspection industrielle, la robotique, le classement de documents ou les agents vocaux d'entreprise. Mais ce socle d'infrastructure légère est exactement le genre de brique que les éditeurs de logiciels créatifs finissent par intégrer en coulisses, dans un module de reconnaissance d'images ou un assistant de montage qui doit tourner sans latence. Le prix et la disponibilité de ces briques se négocient maintenant, bien avant qu'un outil grand public n'en porte le nom.
Les scores affichés face à des modèles bien plus volumineux viennent tous des mesures de Liquid AI elle-même, avec des écarts qui s'inversent selon les tâches : la compréhension visuelle tient la comparaison, le raisonnement logique décroche nettement. Une adaptation sérieuse, comme celle démontrée sur l'inspection d'éoliennes à partir de quelques milliers de photos, suppose un entraînement complémentaire et un jeu de données maison, pas une utilisation telle quelle.
La promesse tient surtout dans l'économie du déploiement : des modèles plus petits à entraîner, plus simples à spécialiser, plus faciles à faire tourner hors ligne que les géants généralistes. Pour une agence ou un studio qui commence à intégrer des outils internes bâtis sur des modèles ouverts, ce basculement vers des moteurs locaux et peu gourmands pèsera tôt ou tard sur le choix des fournisseurs, bien avant d'apparaître dans un menu de logiciel créatif.