Liquid AI construit son propre codec vocal, sous licence plafonnée au chiffre d'affaires
— AUDIOVISUEL
Liquid AI remplace le codec tiers de ses modèles vocaux par LiquidCodec, pensé pour accélérer la synthèse et la reconstruction audio. La licence qui l'accompagne impose une autorisation commerciale distincte dès dix millions de dollars de revenu annuel.
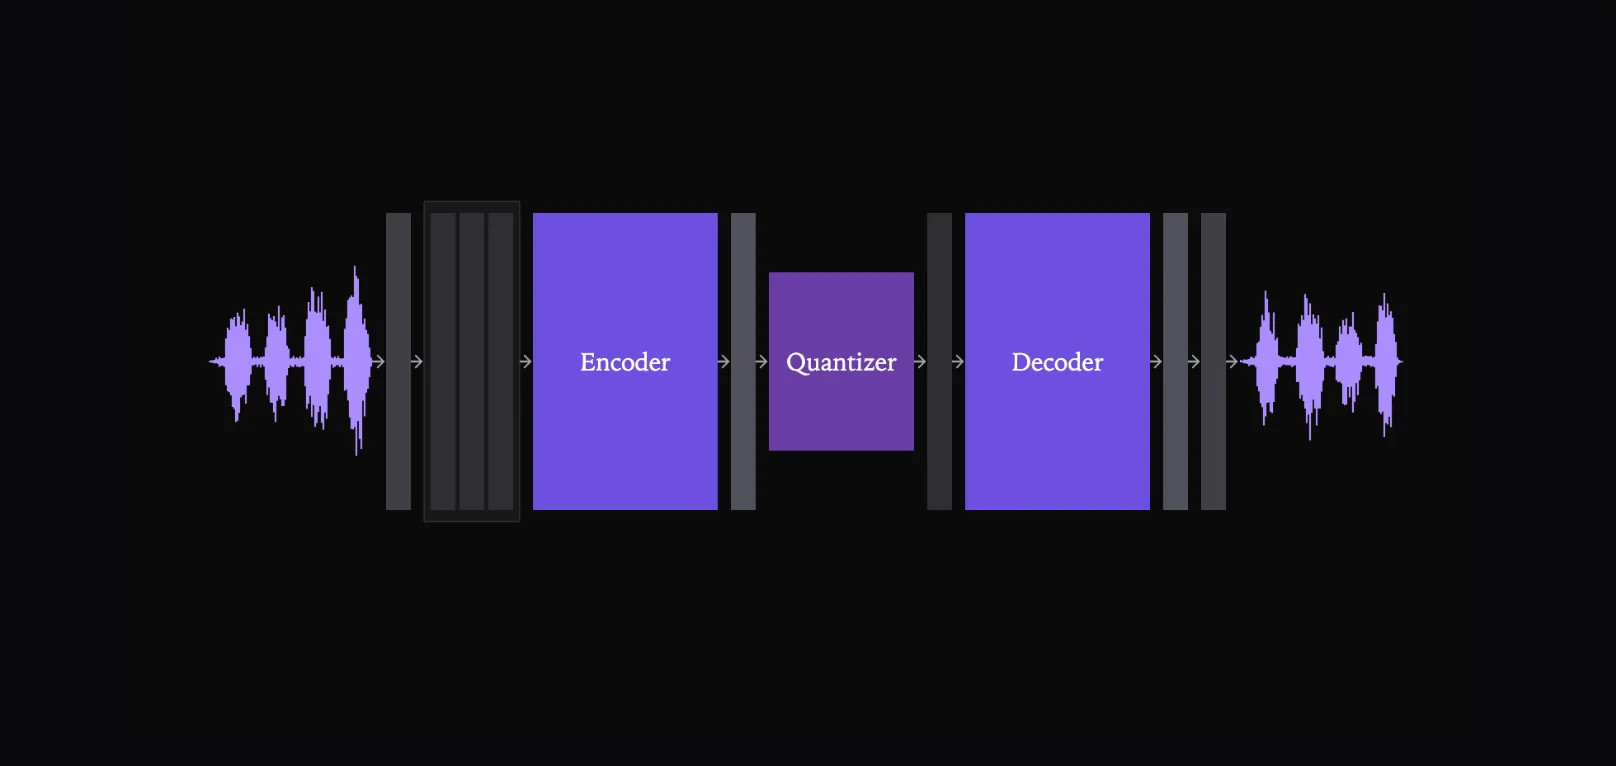
Un studio qui travaille la voix de synthèse ne regarde jamais le moteur qui transforme un son en jetons numériques. Il regarde le résultat : une voix off crédible, un doublage qui ne sonne pas métallique, un temps de rendu tenable sur un projet pressé. LiquidCodec s'attaque justement à cette mécanique invisible, celle qui décide si un modèle vocal répond vite et bien ou traîne derrière une file d'attente de calcul.
Le gain concret tient dans la vitesse de décodage : une seconde de parole reconstruite demande environ onze millisecondes de calcul sur une machine de bureau récente. Pour qui développe des outils de voix IA, doublage automatisé ou assistants vocaux de marque, ce genre de marge se traduit en coût serveur réduit et en latence qui descend sous le seuil où l'utilisateur remarque l'attente.
Les personnes directement concernées restent les équipes qui construisent des produits vocaux au-dessus de ces modèles, pas les graphistes ni les monteurs. Mais la chaîne qui produit des voix de synthèse à bas coût pour la publicité, le e-learning ou les jeux vidéo dépend de ce genre de brique, et son prix de fonctionnement se décide à ce niveau, bien avant d'arriver à l'interface qu'un directeur artistique finira par utiliser.
La licence mérite plus d'attention que la prouesse technique. LiquidCodec est publié en open weights, mais la LFM Open License v1.0 impose une autorisation commerciale séparée dès dix millions de dollars de chiffre d'affaires annuel. Une agence indépendante peut l'exploiter librement ; un groupe média qui l'intégrerait à grande échelle devra négocier.
Sur le terrain des chiffres de qualité, l'avantage affiché reste à nuancer. En français, la version de référence du codec obtient un score de naturel supérieur, mais un taux d'erreurs de mots plus élevé que le concurrent X-Codec 2 sur le même test. Vitesse et fidélité ne progressent pas toujours ensemble, et personne n'a encore mesuré l'effet sur de la musique, du chant ou des ambiances sonores.
Reste un signal de marché net : les fournisseurs de modèles vocaux reprennent la main sur leurs propres briques audio plutôt que de dépendre d'un codec tiers. Pour les studios qui bâtiront demain des outils de voix sur ces fondations, la question à poser dès maintenant concerne le seuil de revenu, pas la performance technique.