Google assemble ses puces IA pour tenir les contextes longs et isoler les données sensibles
— Business
Google colle deux puces existantes pour doubler mémoire et calcul, et ajoute une protection matérielle pendant l'exécution des modèles. Ces accélérateurs tournent derrière les outils cloud déjà utilisés en production, et leur prix futur se négocie sur ce terrain.
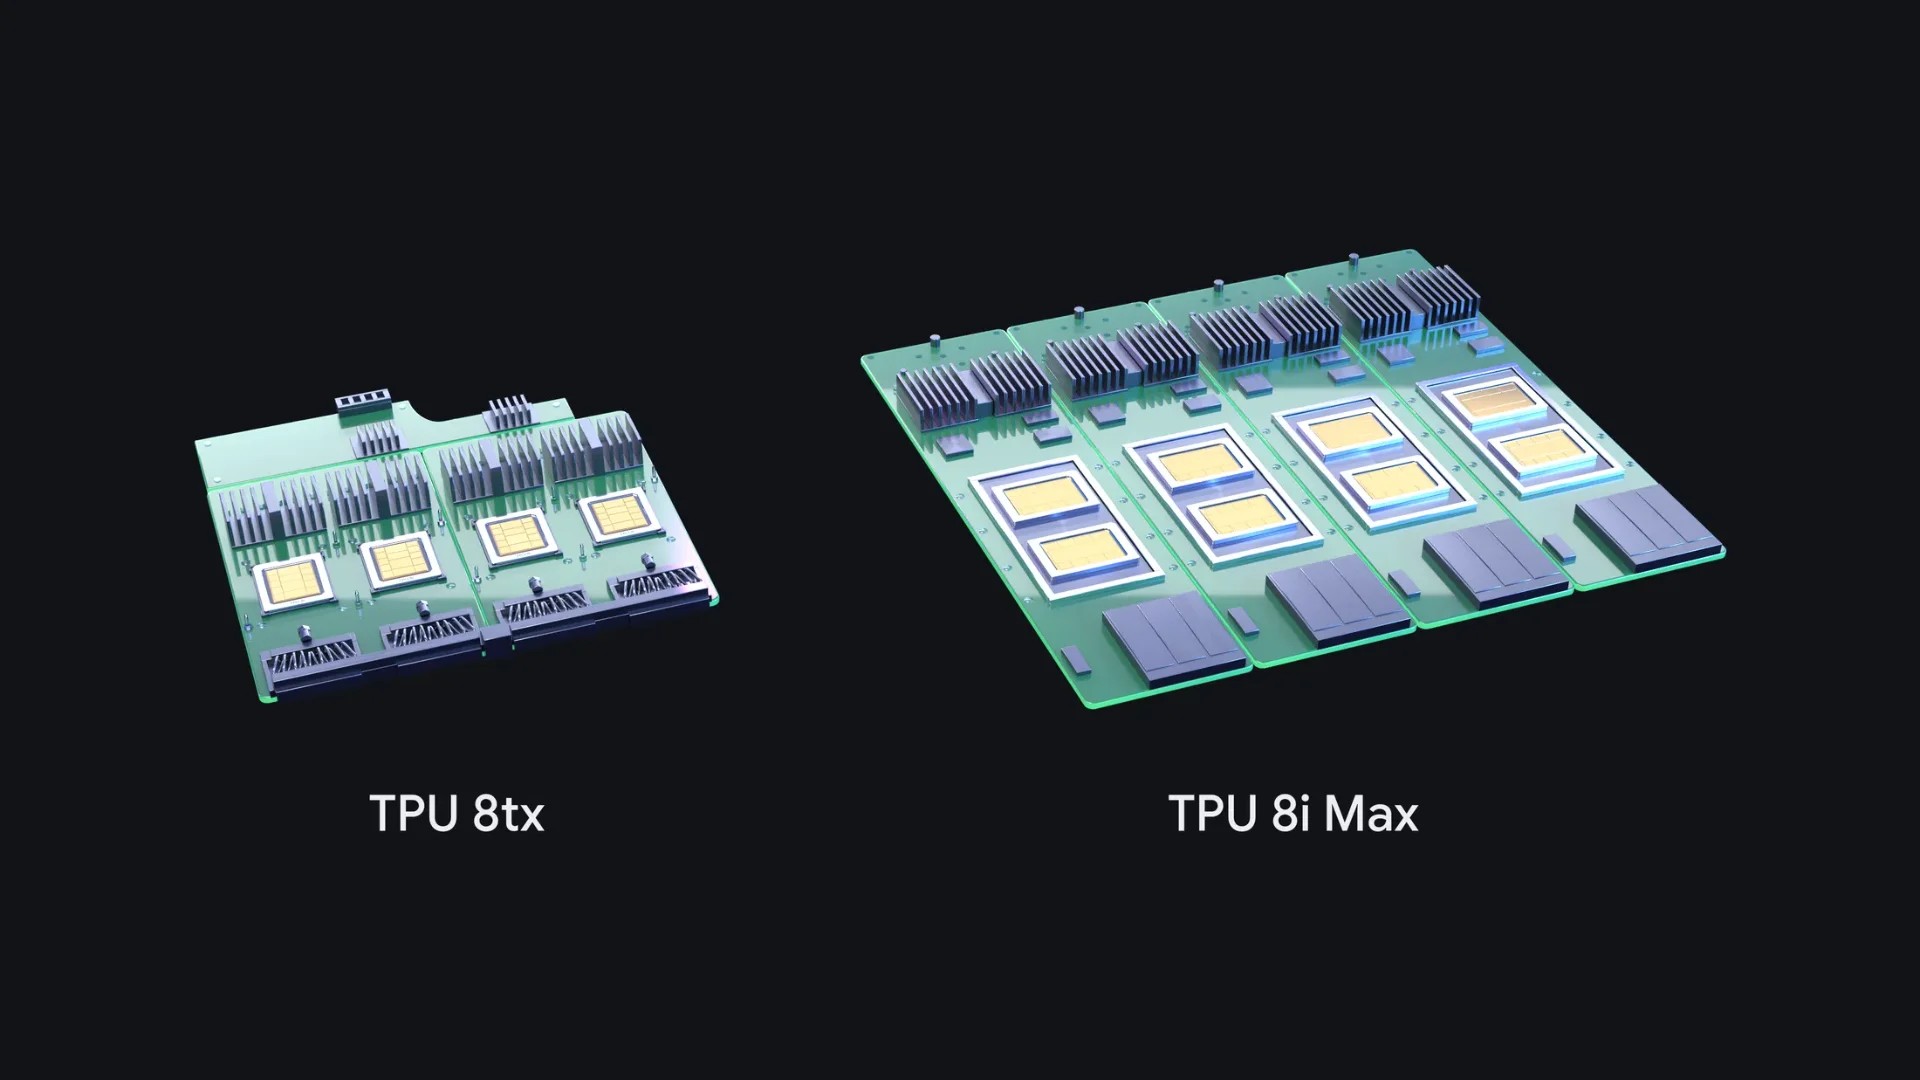
Un boîtier qui réunit deux puces TPU 8i, deux fois plus de mémoire rapide, un débit doublé sur la mémoire à haute bande passante : Google vient de muscler sa génération d'accélérateurs pour tenir des contextes plus longs, un dépôt de code entier ou plusieurs heures de vidéo à analyser d'un coup. Une seconde configuration, le TPU 8tx, ajoute une protection matérielle qui isole les données et les paramètres du modèle pendant leur traitement, pas seulement au stockage ou pendant les échanges.
Ce matériel ne se pilote pas depuis une interface de création. Il tourne dans les salles serveurs de Google Cloud, pour les équipes qui déploient des modèles à grande échelle ou des administrations soucieuses de garder leurs dossiers sensibles sur un même système du début à la fin. L'outil de génération vidéo ou l'assistant de montage qu'un studio utilise déjà repose souvent sur ce genre d'infrastructure sans que personne n'ait besoin d'y penser, et c'est précisément là que se décide son coût futur.
Le chiffre qui parle le plus concrètement : sur un modèle testé en interne, le temps pour récupérer les calculs déjà faits sur une longue consigne tombe de plusieurs secondes à environ 230 millisecondes. Concrètement, un agent chargé d'éplucher des heures de rush ou un historique de conversation long attend une fraction de seconde là où il fallait patienter avant de voir la réponse démarrer.
Ces gains viennent d'essais internes sur une génération de puce antérieure et sur un modèle précis. La fenêtre de contexte qu'un outil propose réellement dépend toujours de la configuration choisie par l'éditeur qui l'exploite, pas uniquement du silicium sous le capot.
Comparé aux générations précédentes, Google consolide une avance sur deux fronts à la fois, l'inférence rapide à long contexte et le calcul confidentiel, deux arguments qui comptent pour les clients d'entreprise bien avant les créatifs. Le rapport de force entre clouds d'IA se joue sur ce type d'annonce, loin des interfaces que les équipes créatives ouvrent chaque matin.
La prochaine fois qu'un outil de génération vidéo annonce une fenêtre de contexte plus large sans augmenter son prix, cette brique silicium y sera probablement pour quelque chose.