Des chercheurs ressuscitent les modèles à énergie pour générer des images
— IMAGE
Des équipes du MIT, de Harvard et de l'Illinois présentent une architecture qui note la cohérence d'une image plutôt que de la reconstruire pas à pas. Les résultats rivalisent avec des modèles de diffusion reconnus sur des catégories fixes d'ImageNet, loin encore des instructions textuelles libres.
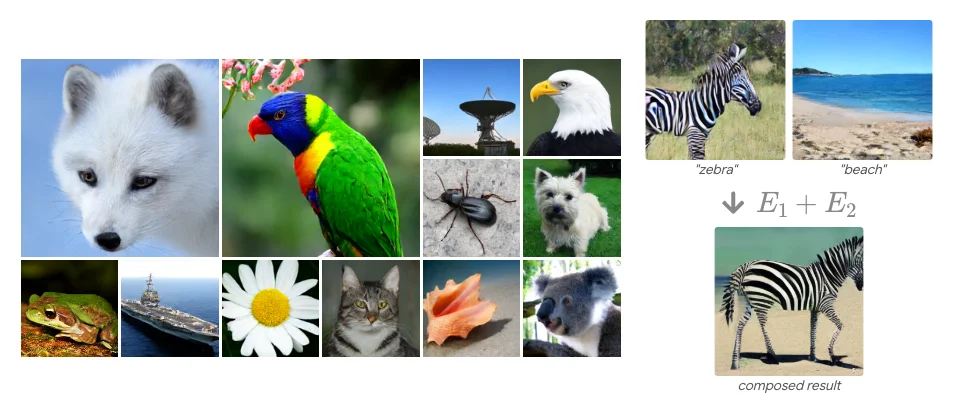
Fabriquer une image en lui attribuant une note plutôt qu'en la débruitant étape par étape : c'est le pari que viennent de valider des chercheurs du MIT, de Harvard et de l'université de l'Illinois. Leur architecture, baptisée TEM, apprend à juger si une configuration visuelle ressemble aux données d'entraînement, puis fait évoluer un bruit aléatoire vers une zone jugée cohérente. L'idée existait depuis des décennies et avait toujours buté sur l'instabilité et le coût de calcul.
Aucun directeur artistique ne branchera cet outil sur un brief client cette année. Les expériences portent sur des catégories fixes d'ImageNet, pas sur des descriptions textuelles ouvertes, et le modèle reste un objet de laboratoire. Ce qui compte ici se joue un cran plus haut, dans les équipes de recherche qui construisent les futurs moteurs des logiciels déjà utilisés en production. Si une architecture alternative à la diffusion démontre sa viabilité à grande échelle, elle finira tôt ou tard par irriguer les générateurs commerciaux qui équipent aujourd'hui les studios.
La démonstration la plus parlante tient à la manière dont le modèle affine une image au moment même de la génération. En laissant tourner le calcul de 40 à 120 étapes, les détails gagnent en netteté et les formes deviennent plus reconnaissables, sans qu'il faille ré-entraîner quoi que ce soit. L'arbitrage ressemble à celui que connaît tout studio entre temps de rendu et qualité livrée, sauf qu'ici le curseur se règle après coup, génération par génération.
Le revers se lit dans les propres observations des chercheurs. Pousser le calcul trop loin fait converger le modèle vers des configurations très proches des données d'entraînement, au détriment de la variété des résultats. Et chaque image continue de coûter de nombreuses itérations, loin de la rapidité des pipelines de diffusion optimisés qui tournent aujourd'hui dans les outils commerciaux.
L'intérêt du travail tient moins à un record de qualité qu'à la preuve qu'une famille de modèles longtemps jugée impraticable retrouve une place crédible dans la discussion scientifique. La capacité à combiner plusieurs contraintes par simple addition, ou à détecter une image qui sort du champ appris, ouvre des usages que la diffusion classique gère plus difficilement. Rien de tout cela ne remplace demain un générateur commercial, mais c'est le genre de brique qui finit par se nicher derrière l'interface d'un outil grand public, et son coût d'entraînement se négocie dès maintenant dans les laboratoires qui la développent.